Datenaustausch mit Prozess Tokens
In diesem Kapitel wird erklärt, wie Flow Nodes ihre Daten über Prozess Tokens an nachfolgende Flow Nodes weiterreichen.
Was ist ein Prozess Token?
Hat eine Flow Node ihre Ausführung beendet, muss Sie das Ergebnis dieser Ausführung festhalten, um es an nachfolgende Flow Nodes weiterreichen zu können.
Für einen User Task kann das beispielsweise der Inhalt eines ausgefüllten Formulars sein. Für einen Service Task die von einem externen Dienst empfangenen Daten.
Dies wird über so genannte Prozess Tokens ermöglicht, die jede Flow Node automatisch generiert und mit ihren Ergebnissen individuell beschreibt.
Prozess Tokens muss stets im JSON Format vorliegen.Arten von Prozess Tokens
Innerhalb des ProcessCubes werden Prozess Tokens auf Zwei Arten dargestellt:
Start Token: Beschreibt den eingehenden Token, den eine Flow Node von ihrem Vorgänger übergeben bekommen hatEnd Token: Beschreibt den von einer Flow Node ausgehenden Token
Beispielprozess Stammdatenerfassung
Nachfolgend wird mit einem einfachen Beispielprozess illustriert, wie der Datenaustausch über Prozess Tokens funktioniert.
Modellierung
Gegeben sei ein Prozess zur Erfassung von Stammdaten.
Die Daten werden über einen User Task in einem einfachen Formular erfasst.
Ein nachfolgender Service Task schickt diese an eine externe Benutzerverwaltung, die außerhalb des Prozesses liegt.
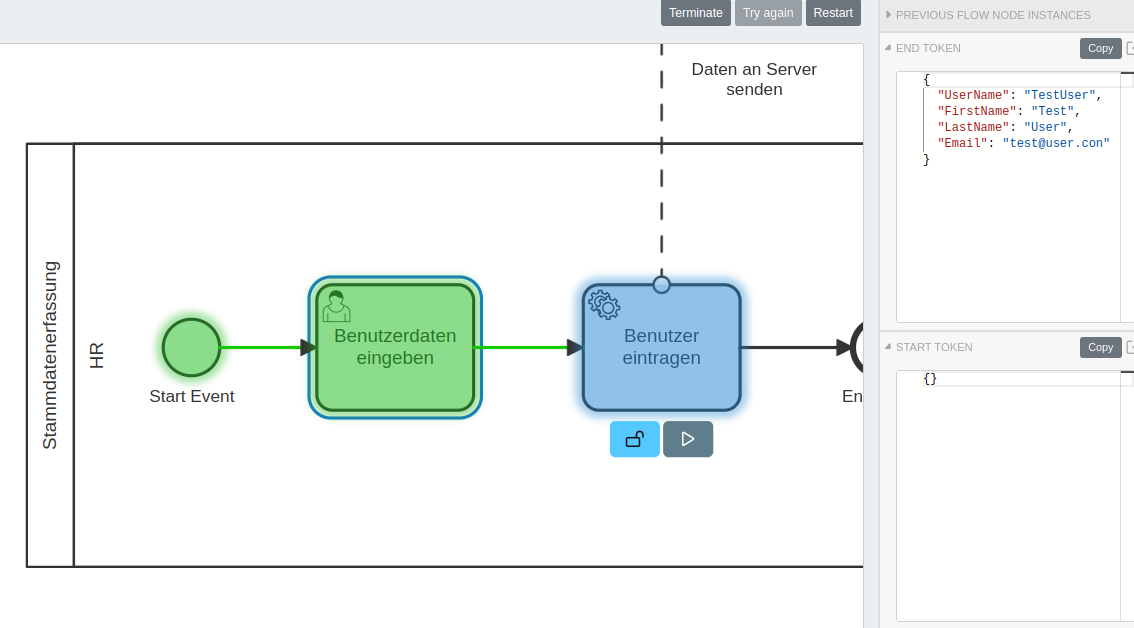
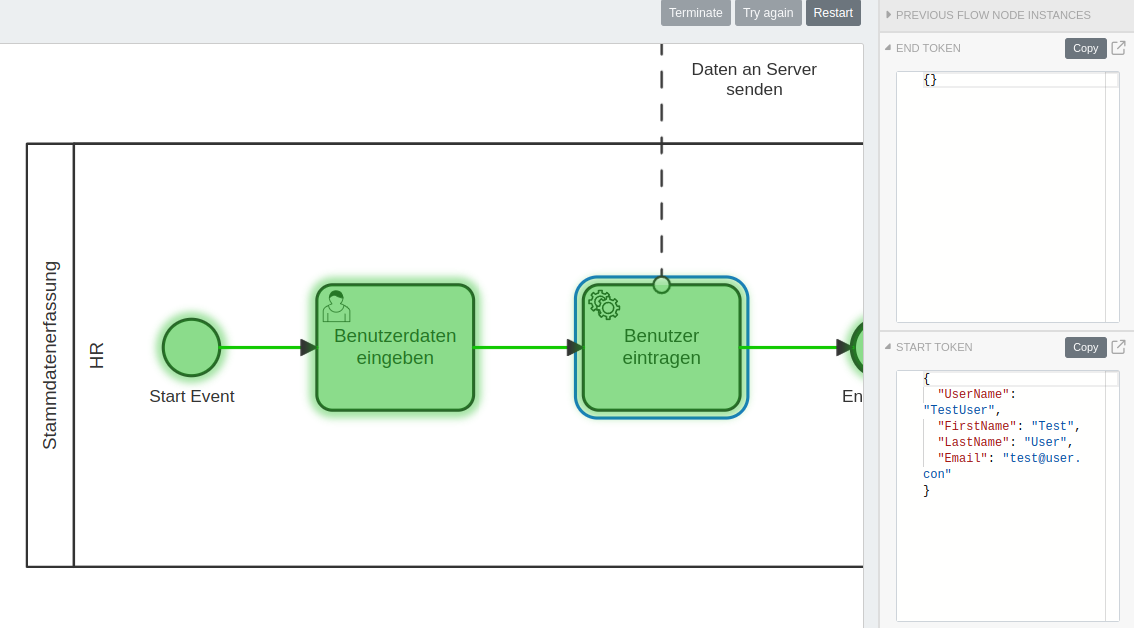
Start Token des Service Tasks entspricht dabei dem End Token des User Tasks.Ausführung
Der Prozess kann über das Studio ausgeführt werden.
User Task
Nach Abschluss des User Tasks, generiert dieser folgendes End Token um die an ihm getätigten Eingaben festzuhalten:
Service Task
Dieser Token wird anschließend an den Service Task weitergereicht, welcher diesen dann als Start Token verwendet.
Daten formatieren
Besonders bei der Kommunikation mit externen Diensten kann es schnell passieren, dass Daten in einem Format übermittelt werden müssen, das nicht menschenlesbar ist. Umgekehrt kann es auch vorkommen, dass die von einer externen Schnittstelle empfangenen Daten in einem nur schwer lesbaren Format vorliegen, oder mit mehr Informationen angereichert sind, als der Prozess tatsächlich benötigt.
Um diesen Umstand zu überbrücken, können an jeder Flow Nodes Skripte definiert werden, um diese Daten in ein passendes, bzw. lesbares Format zu bringen.
Diese Skripte bezeichnet man als Pre Script und Post Script.
Pre Script
Ein Pre Script wird verwendet, um die an einer Flow Node eingehenden Daten in ein neues Format zu konvertieren.
Das kann nützlich sein, wenn man Daten aus einem Drittsystem empfangen hat - z.B. über einen Service Task - und diese Daten nur an einer bestimmten Stelle aufbereiten möchte, um Sie sprechend zu veranschaulichen.
In diesem Fall würde sich nur der Start Token der mit dem Pre Script ausgestatten Flow Node ändern. Die Daten aus dem Drittsystem würden weiterhin im Originalformat vorliegen.
Das Pre Script läuft bevor die Flow Node ihre Arbeit beginnt und überschreibt somit dessen Start Token.
Post Script
Ein Post Script wird verwendet, um die von einer Flow Node ausgehenden Daten in ein neues Format zu konvertieren.
Das kann vor allem dann nützlich sein, wenn man Daten aus einem Drittsystem erhalten hat und diese für den gesamten restlichen Prozess in ein bestimmtes Format bringen möchte.
Das Post Script läuft nachdem die Flow Node ihre Arbeit beendet hat und überschreibt somit dessen End Token.
Erweitertes Beispiel Stammdatenerfassung
Modellierung
Nachfolgend wird obiges Beispiel so modifiziert, dass der Service Task ein Pre-Script und ein Post-Script erhält.
Pre-Script:
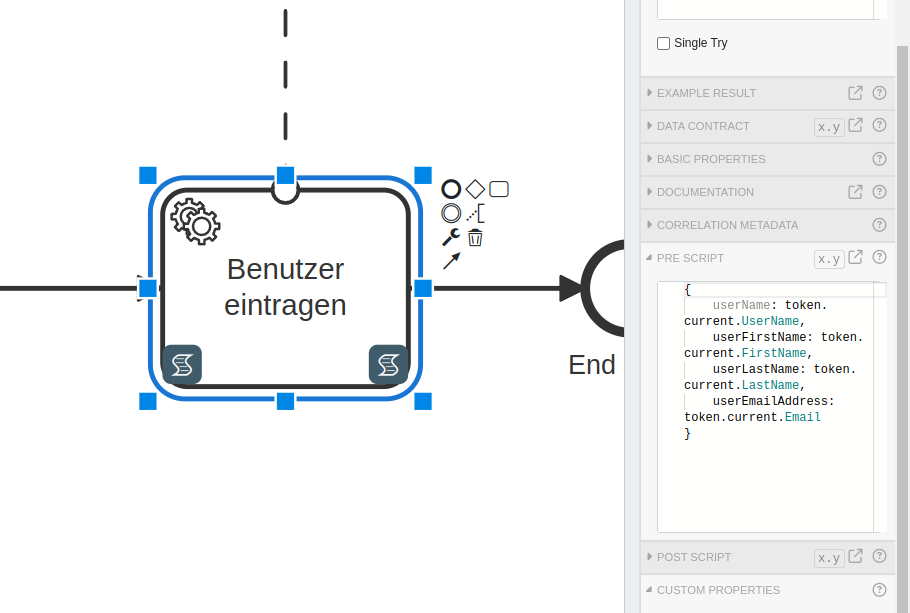
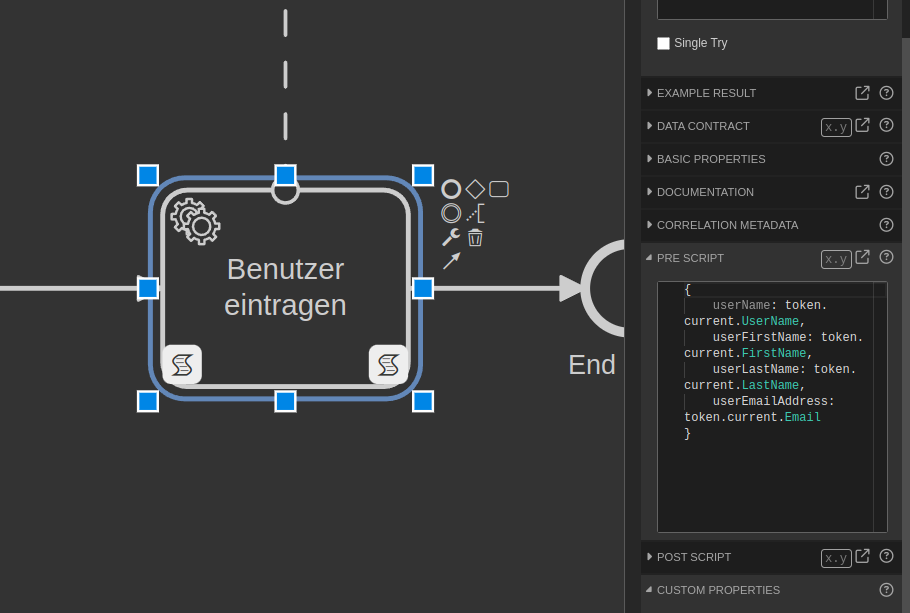
Dieses soll die Eingaben des User Tasks in ein Format bringen, das von dem externen Dienst interpretiert werden kann.
Post-Script:
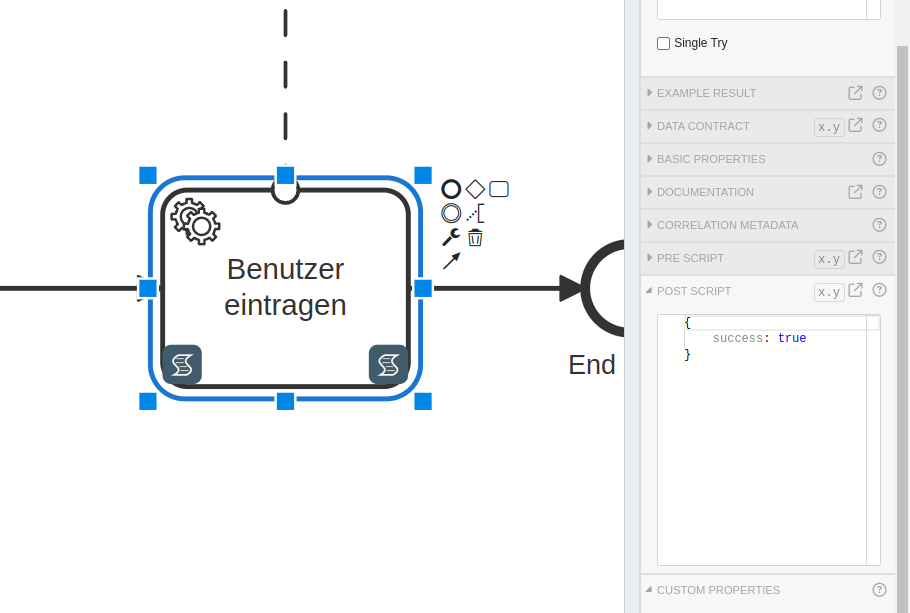
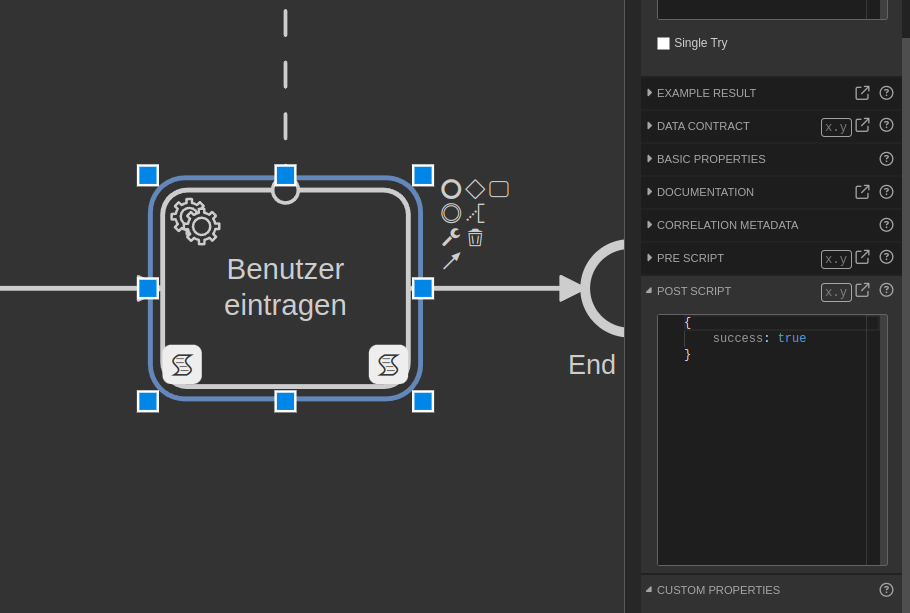
Dieses erzeugt ein neues End Token, in welchem lediglich die erfolgreiche Ausführung des Tasks festgehalten wird.
Ausführung
Führt man den Prozess nun erneut aus, werden für den Service Task folgende Tokens erzeugt:
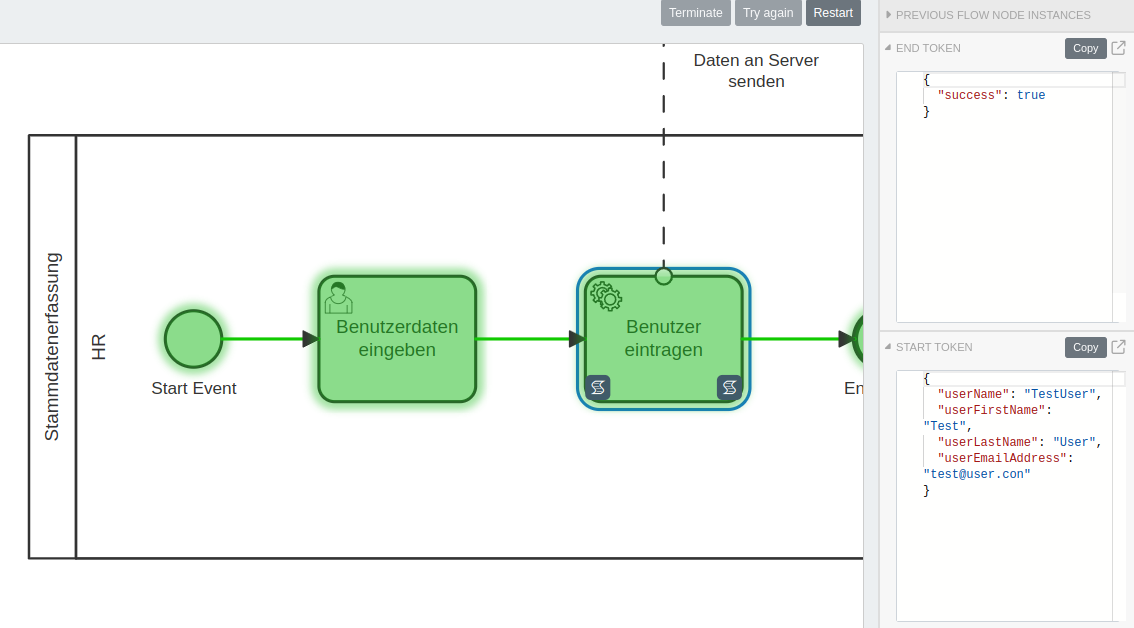
Man erkennt hier sehr deutlich, wie Start Token und End Token durch die definierten Skripte modifiziert wurden.
Runtime Expressions
Die Daten aus einem Prozess Token können mit so genannten Runtime Expressions zur Konfiguration von Elementen verwendet werden.
Möchte man den Inhalt des aktuellen Tokens auslesen, der von der vorhergehenden Flow Node empfangen wurde, kann die Expression token.current verwendet werden.
Eine detaillierte Anleitung zur Verwendung von Runtime Expressions findet sich im Advanced Kurs.
Nächste Schritte
Im nächsten Kapitel wird erklärt, wie die in einem Prozess verwendeten Daten über Data Objects persistiert und für alle Elemente im Prozess verfügbar gemacht werden können.